Beyond Binary Erasure: Soft-Weighted Unlearning for Fairness and Robustness编辑
AAAI 2026 论文,研究用于公平性与鲁棒性修正的软加权机器遗忘。
条目信息
Beyond Binary Erasure: Soft-Weighted Unlearning for Fairness and Robustness 是 乔鑫宝、丁宁宁、程雨诗 和张萌的 AAAI 2026 会议论文。它把机器遗忘重新表述为连续的数据影响修正问题,而不是只能执行“删除或保留”的二元操作。论文关注的是在改善公平性或鲁棒性时,每个样本应保留多少影响,才能避免不必要的效用损失。
概述编辑
论文研究隐私驱动遗忘与修正驱动遗忘之间的差异。在“被遗忘权”场景中,二元删除很自然:一个样本要么保留,要么移除。但在公平性和鲁棒性修正中,目标往往是降低有害影响,同时保留仍然有用的信号。
论文把硬删除带来的失败模式称为 over-unlearning:直接删除可能改善目标公平性或鲁棒性指标,却损害效用、把偏差推向相反方向,或把边界样本当作极端有害样本处理。
方法编辑
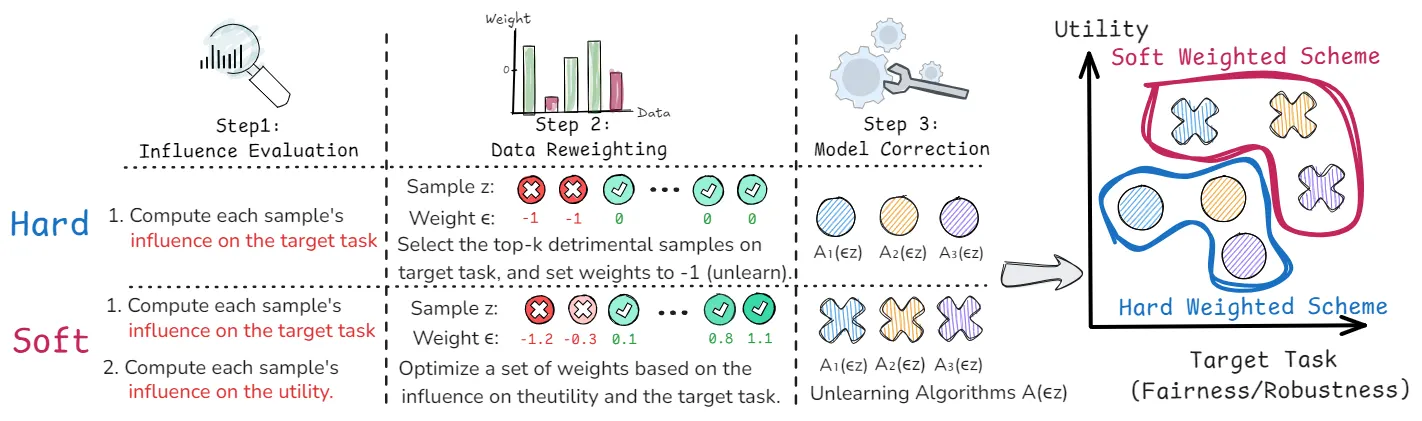
方法用连续样本权重替代二元删除权重。它首先估计每个样本对目标指标与效用的影响,然后求解一个凸二次规划得到定制化权重向量。随后,基于影响函数的遗忘或相关校正方法使用这些权重,按样本的估计作用调整其影响。
三阶段流程为:
- 估计每个样本对公平性或鲁棒性目标以及效用的影响;
- 求解连续权重,使目标指标改善,同时约束效用损失;
- 应用加权模型校正,而不是删除固定 top-k 样本集合。
关键启示编辑
- 修正目标决定数据影响应如何调整。 公平性与鲁棒性干预可能需要降低样本的有害影响,同时保留其中有用的信息。
- 直接删除可能造成过度遗忘。 损害某项指标的样本,仍可能有助于模型的预测性能。
- 连续权重提供更细致的控制。 软加权修正在约束效用损失的同时,调整每个样本保留的影响。
- 机器遗忘也可以用于模型改进。 基于数据影响的更新,能够支持公平性和鲁棒性干预。
结果编辑
实验覆盖表格、图像和文本数据集,包括 Adult、Bank、Jigsaw、CelebA 以及 CIFAR 鲁棒性评估。论文报告软加权方法比硬加权方案更稳定地改善公平性或鲁棒性指标,同时降低效用损失。
留一法(leave-one-out)与影响函数分析显示,对目标指标有害的样本并不总是对效用有害。因此,“删除或保留”的二元规则对修正驱动遗忘而言过于粗糙。
定位编辑
该工作属于 机器遗忘、公平性与鲁棒性、影响函数 和 可信 AI。它补充了 Hessian-Free Online Certified Unlearning:问题从隐私删除转向细粒度模型修正。