Hessian-Free Online Certified Unlearning编辑
ICLR 2025 论文,研究无显式 Hessian 求逆的高效认证机器遗忘。
条目信息
Hessian-Free Online Certified Unlearning 是 乔鑫宝、张萌、唐茗 和 魏尔敏 的 ICLR 2025 会议论文。论文提出一种面向随机训练流程的认证机器遗忘方法,目标是在显式存储 Hessian、求逆 Hessian 或反复重新训练代价过高时,仍能把删除请求转化为在线向量更新。
概述编辑
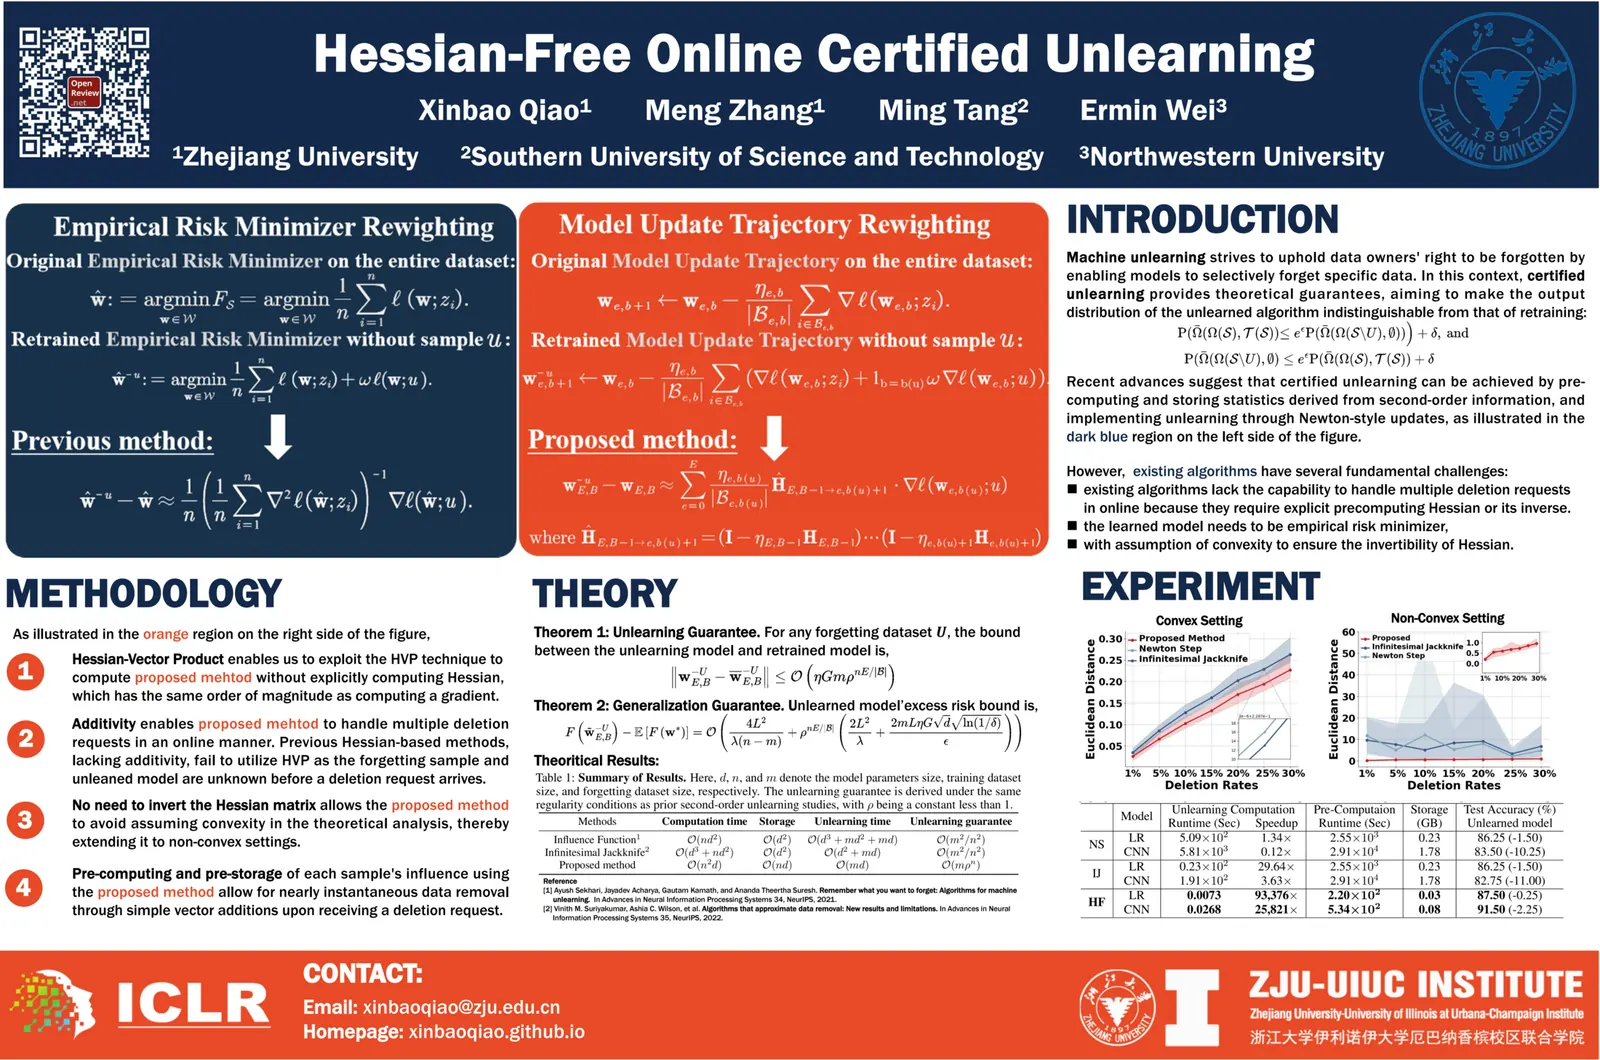
论文研究 认证数据删除。早期认证遗忘方法常使用基于二阶统计量的 Newton 式校正,但在高维或过参数化模型中,构造、存储或求逆 Hessian 都可能不可承受。本文的关键转变是把训练视为一条随机优化轨迹,而不是只看最终最优点。
具体来说,算法为每个样本记录轨迹统计,近似“若该样本在随机训练过程中缺席,模型会如何变化”。这种视角弱化了严格凸经验风险最小化假设,也避免了直接处理完整 Hessian 矩阵。
方法编辑
方法通过仿射随机递推,为每个训练样本累积一个近似影响向量。该向量跟踪完整数据训练模型与删除某样本后反事实模型之间的差异。更新通过 Hessian–向量积计算,无需显式构造完整 Hessian 矩阵,同时保留认证式近似保证。
预计算完成后,在线删除具有加性结构:一批删除请求可以通过求和已存储的逐样本近似向量,并对当前模型施加一次向量更新来处理。
关键启示编辑
- 删除成本取决于训练阶段的设计。 在训练时记录逐样本信息,可以减少收到删除请求后所需的计算。
- 训练轨迹包含可复用的数据影响信息。 保存的轨迹统计支持后续向量更新,无需显式构造或求逆完整 Hessian。
- 效率与认证保证可以共同设计。 该方法将低成本更新与相对于重新训练的形式化近似保证相结合。
- 模型生命周期应包含对未来删除请求的准备。 在训练阶段考虑数据移除,有助于降低后续维护成本。
结果编辑
论文报告毫秒级遗忘执行时间,并相对于基于 Hessian 的认证遗忘基线显著降低时间和存储成本。在大规模应用实验中,该方法通过向量加法删除样本,同时保持接近重新训练的测试精度。
论文还通过成员推断(membership inference)分析,考察多次模型发布可能带来的隐私泄漏风险。
定位编辑
该工作属于 机器遗忘、认证数据删除 和 可信 AI。在乔鑫宝的论文记录中,它是可微模型方向的遗忘工作;DynFrs 则是树模型方向的精确遗忘工作。