DynFrs: An Efficient Framework for Machine Unlearning in Random Forest编辑
ICLR 2025 论文,研究随机森林中的高效机器遗忘。
条目信息
DynFrs: An Efficient Framework for Machine Unlearning in Random Forest 是汪树荣、沈卓洋、乔鑫宝、Tongning Zhang 和张萌的 ICLR 2025 会议论文。该工作把随机森林遗忘视为动态数据结构问题:在保持与重新训练分布等价的同时,降低在线删除、插入和查询延迟。
概述编辑
论文研究 随机森林 的精确高效 机器遗忘。随机森林仍广泛用于医疗、金融和推荐等隐私敏感领域,但树集成结构使标准梯度式遗忘工具难以适用。
DynFrs 面向森林的三类在线操作:预测、样本删除和样本添加。其核心设计目标是在保持精确遗忘所需分布等价性的同时,降低在线修改延迟。因此论文把遗忘视为数据结构与随机算法问题,而不只是模型更新问题。
方法编辑
DynFrs 结合三种机制:
- OCC(q):树子采样规则,使每个训练样本只出现在 棵树中的 棵;
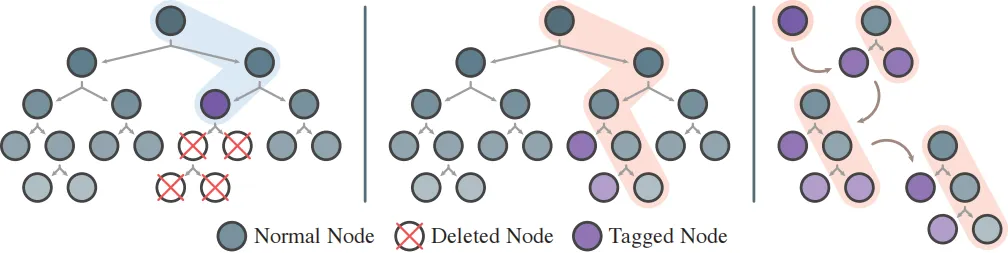
- LZY:延迟标记(lazy-tag)机制,将子树重建推迟到后续查询真正经过受影响路径时;
- ERT:使用极端随机树(Extremely Randomized Tree)作为基学习器,通过随机划分候选降低树结构对局部样本变化的敏感性。
关键启示编辑
- 精确遗忘也可以是数据结构问题。 样本在树中的分配方式与修复操作,需要保证删除后的模型分布与重新训练等价。
- 更新延迟关系到持续服务。 高效的删除机制应控制重建开销,减少对预测请求的阻塞。
- 随机化有助于控制维护成本。 树子采样限制单个样本影响的树数,延迟更新则将重建推迟到真正需要时。
- 传统模型同样需要适应数据变化。 面对持续到来的请求,样本删除、插入与预测需要协同运行。
结果编辑
OpenReview 论文报告 DynFrs 相比已有随机森林遗忘方法实现数量级加速,同时保持或提高预测准确率。论文 PDF 报告相对朴素重新训练有 4000 到 1,500,000 倍加速,相对 DaRE 在顺序遗忘中有 22 到 523 倍加速;在大规模数据集的混合在线流中,修改请求延迟约为 0.12 ms,查询请求约为 1.3 ms。
实验还区分顺序遗忘与批量遗忘。DynFrs 能在两种设置中保持强表现,是因为 OCC(q) 降低每个样本覆盖的树数,而 LZY 避免每次删除都触发完整子树重建。
定位编辑
该工作属于 机器遗忘、随机森林 和 可信 AI。在乔鑫宝的论文记录中,它与 Hessian-Free Online Certified Unlearning 互补:前者关注树集成的精确遗忘,后者关注可微模型的近似认证遗忘。